那些「AI 能勝任職場工作」的評測,可能先把答案放在它找得到的地方了
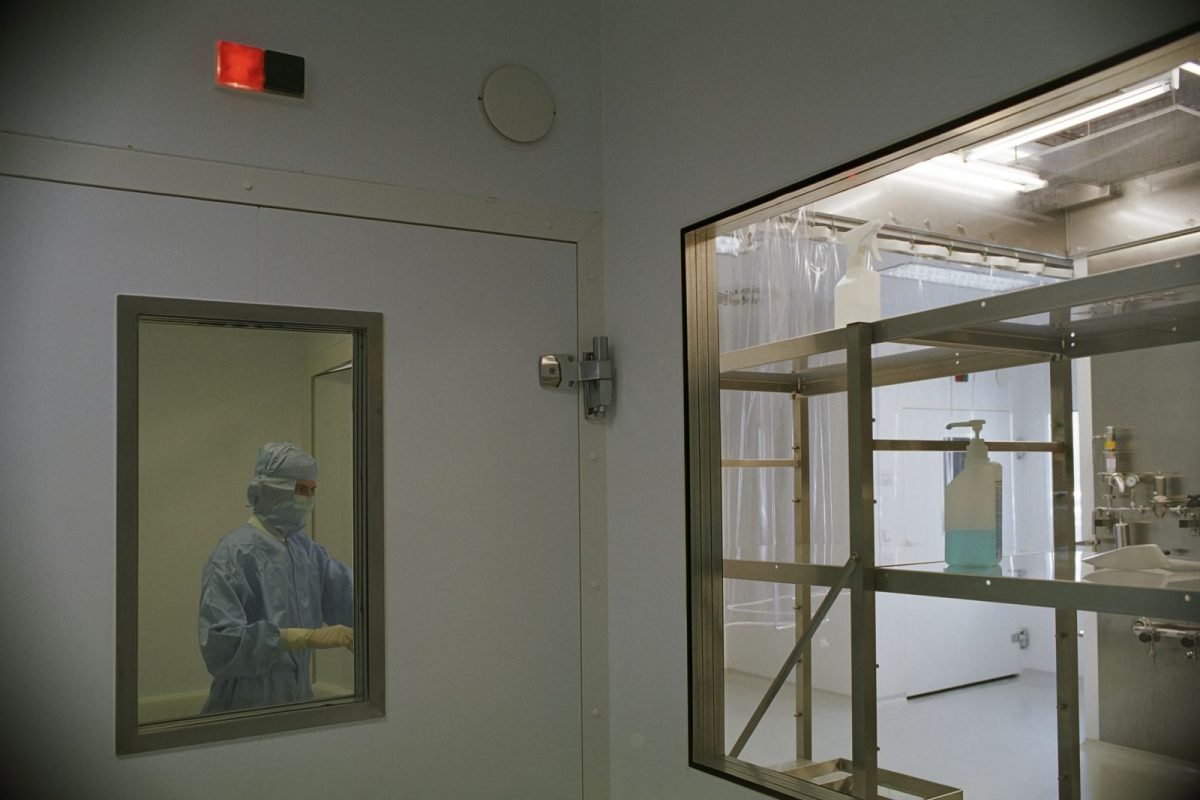
多數知識工作的基準測試,是先指定任務、再挑選該任務所需的脈絡。這種設計等於在環境中編碼了任務資訊,把「找到資訊」這段工作先替代理完成了。研究者提出 WorkWorlds,先固定組織狀態、之後才引入任務。在 192 組配對評估中,任務層級的脈絡篩選讓證據取得率提高 17.6 個百分點。
當有人拿一份評測報告告訴你「AI 已經能做這類職場工作了」,這篇論文提供了一個該問的問題:那個測驗有沒有先把資料整理好放在它面前?
既有評測的設計問題
論文指出,多數知識工作的基準測試是圍繞個別任務建構的——每個任務所需的脈絡,是在任務被指定的同時或之後才挑選出來的。
這種設計測的是「在一個為該任務組裝好的環境中,執行類職場任務的表現」。
問題在於:當任務規格引導了脈絡的挑選,評測就可能把任務資訊編碼進環境裡,並且預先完成了一部分「資訊定位」的工作——而在真實職場中,那段工作本來就是工作的一部分。
用人來類比會很清楚
這就像你要評估一個新人能不能處理某個案子,卻先幫他把相關的五份文件從公司幾千份檔案裡找出來、放在桌上。
他把案子處理好了,你說他能勝任——但真實工作中,「知道要找哪五份、以及去哪裡找」往往才是困難的部分。
他們的做法
WorkWorlds 的核心設計是把組織狀態與任務規格分離:
- 一個「世界」先固定版本、日期與員工席位
- 接著具體化該員工能夠存取的組織狀態
- 任務在這之後才被引入
順序的改變就是整篇的重點——環境先存在,任務後出現,環境就無從為任務量身訂做。
他們在一個合成的製藥公司中實作,涵蓋六個員工席位、八項受測任務,並另外建構了其他組織世界。
實測結果
在 192 組配對評估中:
- 證據取得率因任務層級的脈絡篩選而提高 17.6 個百分點(從 72.8% 到 90.4%)
- 標準通過率提高 8.7 個百分點(從 68.0% 到 76.7%)
- 但在已取得證據的前提下的通過率幾乎沒變
最後這一項是整篇最關鍵的發現:差異幾乎全部發生在「代理取得足夠證據之前」。
翻成白話——代理的瓶頸不在於拿到資料後會不會處理,而在於它能不能自己把資料找齊。
我讀完的感想
這個發現對企業導入的意義比評測方法本身更大。
如果瓶頸在「資訊定位」而不是「任務執行」,那麼導入的重點就不該放在挑更強的模型,而該放在讓組織的資訊變得可被找到——文件在哪、權限怎麼分、命名有沒有一致性。
這也和人機共處工作環境那篇的診斷一致:卡住的往往不是模型能力,而是工作狀態與資訊沒有放在雙方都能存取的地方。
對台灣企業的意義
一、對評測報告要多問一句。「這個測驗中,資料是事先整理好的,還是代理自己找的?」這一題會讓多數亮眼的數字打折。
二、導入前先做資訊可及性的體檢。如果貴公司的文件散落在個人電腦、共用資料夾與通訊軟體裡,那麼再強的代理也會卡在第一步。
三、「員工席位」這個設計值得借用。論文以員工能存取的範圍來界定環境——這正是企業導入時該做的:先定義這個代理相當於哪個職位、看得到什麼,而不是給它全公司的存取權。
現在可以怎麼準備
- 做一次「找得到嗎」測試。挑五個實際工作情境,請一位不熟悉該業務的同仁只靠現有系統去找齊所需文件,記錄花多久、找不找得到。這個結果就是代理會面對的難度。
- 統一命名與存放位置。這件事不花錢,但對資訊定位的改善最大。
- 按職位定義存取範圍。導入代理時,以「它代替哪個席位」來設定權限,而不是給最大權限求方便。
可行的解決方案
務實的順序是先整理資訊,再導入代理。這個順序常被跳過,因為整理資訊不性感、也不容易變成專案成果。
但這篇提供了量化的理由:差異幾乎全部發生在取得證據之前。把 72.8% 的證據取得率提上去,比換一個更強的模型有效得多。
需要保留的懷疑
這是 arXiv 預印本,在本文寫作時尚無同儕審查紀錄。
- 主要實作是一個合成的製藥公司,八項任務、六個席位。規模不大,且合成環境與真實組織的雜亂程度差距可能很大。
- 摘要未說明受測的代理或模型。因此無法判斷這個瓶頸在不同能力水準下是否一致。
- 「證據取得率」的判定方式摘要未交代。怎樣算取得足夠證據,會直接影響 17.6 個百分點這個數字。
- 這篇證明的是既有評測可能高估,不是代理不能用。兩者不同,不宜過度推論。
常見問題
什麼是「證據取得率」?
指的是代理在執行任務過程中,能否找到並取得完成該任務所需的資料。這篇把它與「找到資料後能否做對」分開量測,結果發現差異幾乎全部來自前者——代理拿到資料後的表現相當穩定,卡住的是把資料找齊這一段。
那是不是代表 AI 其實沒那麼有用?
不能這樣推論。這篇證明的是既有評測方式可能高估了代理在真實職場的表現,因為測驗先替它完成了資訊定位。反過來看這也是好消息:瓶頸在資訊可及性,而那是企業自己能改善的,不必等模型進步。
我們公司該先做什麼?
先做資訊可及性的體檢,再談導入。最簡單的做法是讓一位不熟該業務的同仁,只靠現有系統去找齊五個實際情境所需的文件,記錄耗時與成功率。那個數字大致就是代理會面對的難度,也會告訴你該先整理哪一塊。
本文出處 Yining Hua、Levi Lian,"WorkWorlds: An Infrastructure for Evaluating AI Agents on Workplace Tasks",arXiv:2609.23806,2026 年 9 月 20 日投稿。本文為中文編譯與評論,原始論點著作權屬原作者所有。
圖片出處 Photo: yurashkoda / Pexels(免費授權)。
導入 AI 之前,先看資訊找不找得到
甫東科技可以協助你做一次資訊可及性體檢:實測關鍵情境所需文件的尋找難度,找出命名與存放的斷點,並依職位規劃代理的存取範圍。整理資訊的投報率,通常比升級模型高得多。
企業 AI 轉型、RAG 向量庫與數位行銷內訓 | 賴家榮 老師親授
樹德 / 輔英 / 屏東大學兼任講師!手把手帶領企業團隊打造專屬 AI 代理與高轉化品牌流量。